個人開発の英単語アプリを作り直した(1) — ReactもVueも使わない技術選定

自分用に作っていた英単語の学習アプリ(language_learn_app)を、作り直しました。
せっかくなので、その作成記録を技術記事として3部作でまとめてみます。
- (1) 全体像と技術選定 ← この記事
- (2) AIプロバイダの抽象化(Claude / Gemini を設定だけで差し替える)
- (3) 学習体験の作り込みと、Raspberry Pi での運用
1本目は「技術選定」の話です。
どんなアプリか
ひとことで言うと、AIが単語情報を作ってくれる自分専用の単語帳です。
英単語を入れると、意味・IPA発音・例文・文法タグをAIが生成してくれる。あとはテストで覚える、というかなりシンプルなアプリです。
構成はこの2本柱です。
| ディレクトリ | 中身 |
|---|---|
server_app/ |
Python(FastAPI + HTMX)の Webアプリ |
smartphone_app/ |
Flutter のスマホアプリ(ただライセンスを買うのが勿体無かったのでiPhoneでテストしかしていません) |
この記事では、メインの server_app/(Web側)の技術選定を扱います。
動機:「個人開発で重いJSフレームワークは要るのか?」を確かめたかった
個人開発って、ビルドや状態管理の重さで挫折しがちなんですよね。
React や Vue を持ち出すと、それだけで環境構築・ビルド・状態管理…と考えることが一気に増える。一人で素早く形にしたいのに、土台づくりで力尽きる。
なので今回は、あえてJSフレームワークを入れずにどこまでリッチに作れるかを自分の手で確かめてみました。
技術スタック:全部CDN、ビルドステップ0
選んだのはこれです。
| 項目 | 技術 |
|---|---|
| Web framework | FastAPI |
| テンプレート | Jinja2(サーバサイドレンダリング) |
| フロント | HTMX + Alpine.js + Tailwind CSS(すべてCDN) |
| ORM / DB | SQLAlchemy 2.0 + SQLite(1ファイル) |
| 設定管理 | pydantic-settings |
| パッケージ管理 | uv |
| Python | 3.12+ |
ポイントは、フロントのHTMX・Alpine・Tailwindを全部CDNから読み込んでいること。npm install も webpack も無い。ビルドステップがゼロなんです。
HTMXは「サーバが返したHTML片を、ページの一部に差し替える」ことをやってくれるライブラリです。ボタンを押すとサーバが部分HTMLを返し、それを画面の該当箇所にスワップする。これだけで、ページ全体をリロードせずにリッチに動く。
状態は基本サーバ(とDB)が持つので、クライアント側に重い状態管理を持ち込まなくていい。この「サーバサイド中心で完結させる」感覚が、一人で作るにはとても軽いんですよ。
このあたりは以前から「HTMXでJSフレームワーク無しのリッチUIを作る」という構想はあったのですが、実際に一本アプリを通してみて確信に変わりました。
実証:フロントのJSは20行で済んだ
「本当にJSフレームワーク要らないの?」への一番の答えがこれです。
このアプリの自前JS(static/js/app.js)は、たった20行でした。
やっていることは2つだけ。
- htmxがHTMLを差し替えた後(
htmx:afterSettle)に、その中のAlpineコンポーネント(x-data)を再初期化する - フォームの二重送信を防ぐ
これだけです。画面遷移のロジックも、データの取り回しも、状態同期も、ほぼサーバ側にある。クライアントJSは「差し替え後のつなぎ込み」しかしていない。
SPAフレームワークが無いと不便では?と身構えていたんですが、少なくとも「自分用の単語帳」の規模では、まったく困りませんでした。
アーキテクチャ:core / features で分けて、依存を一方向に縛る
技術選定と並んで意識したのが、コードの構造です。
core/(共通基盤)と features/<機能名>/(個々の機能)に分けて、依存の矢印を features → core の一方向だけに縛りました。
features は words / ai / quiz / streak / export / settings に分かれていて、各機能が models.py / schemas.py / router.py / service.py の4点セットで統一されています。
さらに features 同士の依存も一方向だけに固定しました。
core ← features/*(words, ai, quiz, streak, export)
words ← quiz, export
quiz  ← export
streak ← export
逆方向・循環は禁止。これを守ると、機能を足す・消すときに土台へ波及しないんですよ。features は core に乗るだけの独立した箱になるので、影響範囲が読めるし、テストも書きやすい。
レイヤーを切るだけでなく「矢印の向き」まで規約として決めておくのが肝だと思っています。
AIと一緒に作るなら、規約を「AIへの指示」にしてしまう
この一方向依存のルールは そのまま Claude Code への指示ファイル(CLAUDE.md)に書いてみました
個人開発をAIと共同で進めると、放っておくとAIは平気で循環参照を作ります。「features同士は一方向のみ、逆方向・循環は絶対禁止」と明文で渡しておくと、境界があるぶん指示が局所化できて、事故が減る。
自分向けのコーディング規約を、そのままAIのガードレールに転用できる。これはAI時代の個人開発ならではの実感でした。
ハマりどころ:マイグレーションどうする問題
SQLite1ファイルで気軽に始めたものの、スキーマ変更のたびにDBを作り直すのは面倒です。
かといって個人用アプリに Alembic を持ち込むのも重い。
そこでやったのが、起動時のミニマイグレーションです。アプリ起動のたびに、必要な ALTER TABLE ... ADD COLUMN を try/except で試すだけ。既にカラムがあれば例外を握りつぶす。
さらに app_meta テーブルにバージョン番号を持たせて、「アプリのバージョンが上がった時だけ」データ正規化処理を走らせるようにしました。
Alembicほどかっちりはしていないけど、一人で使うぶんにはこれで十分回ります。個人開発は、こういう「ちょうどいい雑さ」の設計が効くなと思っている反面、正規にリリースするときに障害になりそうだなと思いました。
なお、認証は今のところ入れていません。自分専用のシングルユーザーアプリとして割り切っています(この割り切りが、後の運用編でTailscaleを選ぶ理由につながります)。
まとめ
1本目のまとめです。
- 個人開発のWebアプリは、FastAPI + HTMX + Alpine + Tailwind(全部CDN) でビルドステップ0にできる。
- 実際、自前JSは20行で済んだ。SPAフレームワークは「自分用アプリ」の規模なら要らない、を自分の手で確認できた。
- コードは core/features で分け、依存を一方向に縛る。その規約をそのままAIへの指示にすると、AI協働の事故が減る。
- マイグレーションは起動時ミニマイグレーションで軽く済ませる。個人開発は「ちょうどいい雑さ」が効く。
次回は、このアプリの一番のキモである AIプロバイダの抽象化 — Claude と Gemini を .env の設定だけで差し替える仕組みを書きます。
ではでは。
参考
【uv】pyenv + venv + poetry から卒業してuvに一本化した話

Python の環境構築、毎回ちょっとだけ憂鬱じゃないですか?
pyenv で Python のバージョンを入れて、venv で仮想環境を切って、依存は pip か poetry で…と、
ツールがバラバラだと「あれ、このプロジェクトどうやって作ったんだっけ」と毎回思い出す羽目になります。 自分もずっとそうでした。
それが uv に一本化したら、環境構築から Python のバージョン管理、依存、ツール導入まで、 ぜんぶ uv ひとつで片付くようになりました。
今回はその「環境構築」と「バージョン管理」のところを、 自分が使っているコマンド中心にまとめてみます。
uv とは(ざっくり)
uv は Astral 製の、Python のオールインワン管理ツールです。
- 仮想環境(venv 相当)
- 依存関係・パッケージ管理(pip / poetry 相当)
- Python 本体のバージョン管理(pyenv 相当)
- CLI ツールの導入(pipx 相当)
これらを1つにまとめてくれて、しかも爆速。「pip も venv も pyenv も poetry も」だったものが、 uv だけ覚えればいい状態になります。
インストールは Mac / Linux なら curl 一発です。
curl -LsSf https://astral.sh/uv/install.sh | sh
uv self version   # バージョン確認
1. 環境構築:プロジェクトを作る
新しいプロジェクトはこれだけです。
uv init my_project      # プロジェクト雛形を作成
cd my_project
uv add pandas matplotlib  # 依存を追加(pyproject.toml に書き込まれる)
uv add すると pyproject.toml の dependencies に追記され、同時に uv.lock も更新されます。
仮想環境(.venv)は uv が勝手に作って勝手に使ってくれる ので、source .venv/bin/activate を
打つ必要すらありません。実行はこう。
uv run python main.py   # .venv 経由で実行してくれる
uv run pytest           # テストもこれでOK
依存まわりで自分がよく使うのはこのあたりです。
| コマンド | 何をする |
|---|---|
uv add <pkg> |
依存を追加 |
uv remove <pkg> |
依存を削除 |
uv lock |
ロックファイル(uv.lock)を更新 |
uv sync |
ロックに合わせて .venv を同期 |
uv tree |
依存ツリーを確認 |
2. Python本体のバージョン管理
ここが地味に大事なところ。uv は Python 本体も管理できます。
uv python install 3.11 3.12 3.13   # 複数バージョンを入れられる
uv python list                     # 入っているもの一覧
そして、プロジェクトごとに使う Python を固定するのが uv python pin です。
uv python pin 3.13
# → Updated `.python-version` from `3.11` -> `3.13`
これで .python-version というファイルが作られ、uv はこのプロジェクトでは常に 3.13 を使ってくれます。
.python-version と requires-python は別物
最初ここで混乱しがちなので整理しておきます。
| 書く場所 | 役割 |
|---|---|
.python-version |
開発環境でどの Python を使うか(自分の手元の固定) |
pyproject.toml の requires-python |
パッケージのメタdataとして、対応する Python の範囲 |
手元で動かす版を決めるのが .python-version、配布物として「3.11以上対応です」と宣言するのが
requires-python、という住み分けです。
ハマりどころ: pin したのに思ったPython バージョンにならない
自分が最初にハマったのが「pin した覚えのない 3.11 になっている」現象でした。
これは uv python pin 3.12 のように マイナーまでしか指定しない(loose)と、
手元にある最新の 3.12.x が使われるためです。
パッチまでカチッと固定したいなら、フルバージョンで pin します。
uv python pin 3.12.7   # パッチまで固定
uv lock                # 制約に合わせて依存を再解決
uv sync                # .venv をその版で作り直してくれる
uv sync は、インタプリタが変わると .venv を勝手に作り直してくれるので、
仮想環境を手で消して作り直す必要はありません。ここが地味にラクです。
3. プロジェクトの「バージョン」を管理する(セマンティックバージョニング)
Python の版だけでなく、自分のプロジェクト自身のバージョン(1.2.3 みたいなやつ)も uv で扱えます。
uv version              # 今のバージョンを表示
uv version --bump patch # 1.2.3 -> 1.2.4
uv version --bump minor # 1.2.3 -> 1.3.0
uv version --bump major # 1.2.3 -> 2.0.0
uv version --bump は pyproject.toml の version 文字列を直接書き換えるので、
pyproject.toml が常に「正」 になります。あとはこれを git tag と組み合わせて、
- コミット単位の小さな変更 → build / patch を上げる
- 機能追加 → minor を上げる
- 大きな構造変更 → major を上げる
というルールで運用し、bump したらタグを切る、という流れにすると管理がブレません。 簡単な bash スクリプトにまとめれば、bump → changelog → git tag → push まで一発にできます。
4. CI / Docker でも「同じ版」を使う
手元と CI とで Python の版がズレると、ローカルで通ったのに CI で落ちる、という事故が起きます。
uv なら .python-version を共通の真実にして揃えられます。
- GitHub Actions:
astral-sh/setup-uvで uv を入れて、uv syncでピン留めされた版を入れる - Docker:
uv syncの前に.python-versionをイメージにコピーしておく
これで「ローカルと CI と本番が同じ Python で動く」状態になります。 環境はなるべく統一して、毎回悩まないようにしておくと、後がずっとラクです。
まとめ
uv に寄せてよかったのは、結局これに尽きます。
- 環境構築:
uv init→uv add→uv run。.venvは uv が面倒を見る - Pythonの版:
uv python install/uv python pin(loose と exact を使い分ける) - プロジェクトの版:
uv version --bumpで pyproject.toml を正にして semver 運用 - CI/Docker:
.python-versionを共通の真実にして全環境を揃える
道具がバラバラだと環境構築のたびに悩みますが、uv に統一すると「毎回同じやり方」で再現性が上がります。 新しいマシンでも、新しいプロジェクトでも、同じ手順で立ち上がる。これがいちばんの時短だと思います。
ではでは。
参考
【Git】Gitリポジトリを複製する方法【Duplicate】【複製】
Gitリポジトリを複製する方法
概要
最近Dockerで開発環境を作り、その上にアプリを作ったりすることが増えたため、このDocker環境をコピーして使うことが増えてきました。
ただいざ久しぶりにGitにあげたDockerfileなどを複製するとなるとやり方がパッと分からなかったりするので、備忘録としてまとめておきます。
複製方法
ステップは4つです。
基本的な流れとしては
- コピー先となるリポジトリを作成する
- ローカルに--bareオプションを付けてコピー元のリポジトリをクローンする(ベアリポジトリの作成)
- クローンしたコピー元のリポジトリを--mirrorオプションを付けてコピー先のリポジトリにpushする
- クローンしたコピー元のリポジトリをローカルから削除
コピー先となるリポジトリを作成する
リポジトリの作成はGithubであれば画面右上のCreate Repositoryから新規に作成します。
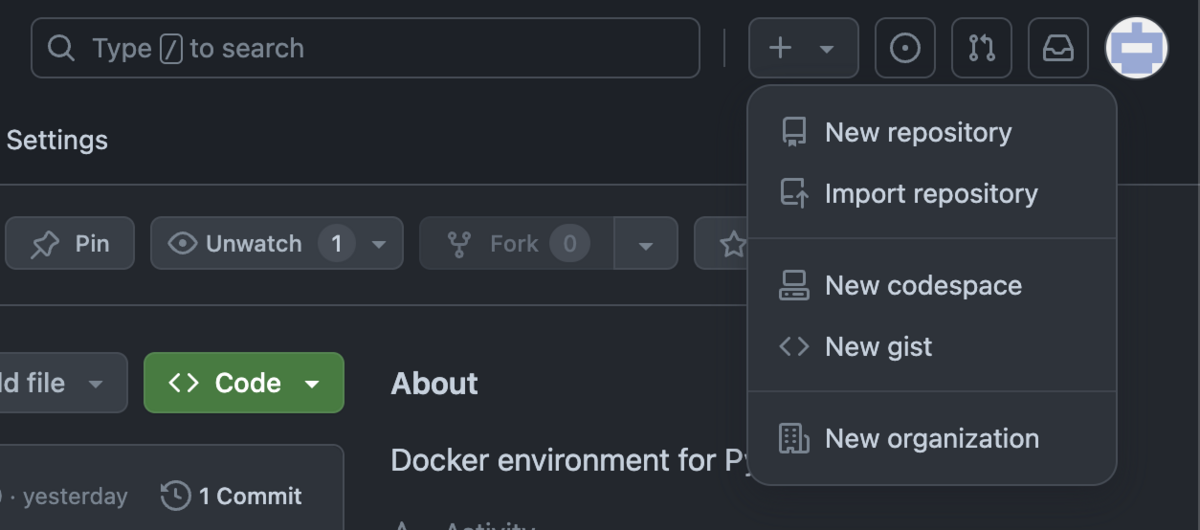
ここではつい今日私自身がやったJavascript用のrepositoryとして作ったこちらにコピーすることを想定してみます。
ローカルに--bareオプションを付けてコピー元のリポジトリをクローンする(ベアリポジトリの作成)
ここではこちらのPython用のDocker環境を複製していきます。
まずはローカルの適当な場所に--bareオプションを付けてクローンします。
git clone --bare https://github.com/RYO0115/python_docker_env.git

クローンしたコピー元のリポジトリを--mirrorオプションを付けてコピー先のリポジトリにpushする
次にこのベアクローンを新しいコピー先のリポジトリにコピーしていきます。
まずはクローンしたリポジトリに移動。
cd python_docker_env
その後--mirrorオプションを付けてpushします。
git push --mirror https://github.com/RYO0115/js_docker_env.git
そもそも--bare, --mirrorは何をしているの?
--bare
こちらの記事を参考にさせていただきました。
平たく説明するとGitのリポジトリにはベアリポジトリとノンベアリポジトリの2種類が存在します。
これらの大きな違いはワーキングディレクトリと呼ばれる、所為我々が編集するソースコードなどの実態の有無になります。
ソースコードなどの実態がある方がノンベアリポジトリ、逆に更新管理の情報のみを含んだものがベアリポジトリとなります。
なので今回のようにただリポジトリを複製するだけであれば、更新管理情報のみがあれば十分なため、--bareオプションを付けていることになります。
--bareオプションを外した状態でも同じようにpushでき、履歴も含めて引き継がれているので、おそらくベアリポジトリにある更新管理情報のみで情報が十分と言うことで--bareオプションを付けているのだと思われます。(公式サイトでも--bareを推奨しているが、明確な説明はないので、自分はこのように理解しています)
--mirror
ミラーリングをするオプションです。
ブランチやタグ情報をまとめてコピーするオプションになります。
こちらをつけることでブランチ、タグ、プルリクエストの情報などをまとめてコピーすることができます。
最後に
以上でリポジトリの複製方法の紹介になります。
意外と使うのに忘れてしまいがちなので、こういった内容は適宜メモ書きとして投稿していきたいと思います。
また今回でベアリポジトリと言う存在を理解できたのも良かったです。
ではでは。
【C++】 C++でマルチスレッドのクラスを作ってみたよ【マルチスレッド】【サンプル】
C++でマルチスレッドのクラスを作ってみたよ
概要
以前、C++のマルチスレッドについて説明し、サンプルを書きました。
それ以降、業務内でマルチスレッドのアプリを作ることが頻繁にあったので、今回はマルチスレッドのみにフォーカスしたクラスを作ってみたので紹介したいと思います。
リポジトリ
cpp_test/SampleThreadが今回のサンプルプロジェクトになります。
使用方法
こちらのリポジトリをクローンしていただき、SampleThreadディレクトリ内にbuildディレクトリを作ってください。
その後、以下のコマンドを実行します。
cmake ..

make
これでサンプルがbinディレクトリの中に生成されるので、動かすことができます。
サンプルの内容
サンプルの内容はシンプルです。
SampleThreadクラスがメインスレッドとは別に100ms周期で動いていて、常にカウンタ(counter)を更新し、更新したカウンタを適当な変数(value)に加算し続けます。
メインスレッドも同じく100msで動いており、1秒に1回(10回に1回)この_valueを適当な数字に書き換えます。
マイループ、メインスレッドはSampleThreadクラスからcounterとvalueの値を取り出し、画面に表示すると言うプログラムです。
具体的に中身を見ていきましょう。
メイン
メインは今回testディレクトリ内に作っています。(今回作ったSampleThreadクラスの動作テストなのでtest内にしました.srcの中でも問題ありません)
main関数では頭でSampleThreadを宣言し、SampleThreadクラスのスレッドをスタート(GenerateThread())し、ループを回し始めます。
SampleThreadクラスから値を取り出すのは各種Get関数を使っています。
またSampleThreadクラスに値をセット(リセット)する際もResetValue()関数を使用します。
では次にSampleThreadクラスの中を見ていきます。
#include "thread_sample.hpp"

int main(void)
{
    SampleThread st;
    const int sleep_msec = 100;

    st.GenerateThread();
    int counter = 0;
    int value = 0;

    while(1)
    {
        counter = st.GetCounter();
        value = st.GetValue();

        printf("Counter: %d Value:%d", counter, value);

        if(counter % 10 == 0)
        {
            printf(" --> Value Reset");
            st.ResetValue(10);
        }
        printf("\n");

        std::this_thread::sleep_for(std::chrono::microseconds(sleep_msec));
    }

    st.CloseThread();
    return(0);
}
SampleThreadクラス
sample_thread.hpp
まずはHeaderです。
ここで必要な変数、変数の値を取り出す、セットするための関数、別スレッドで回すmain関数、mutex, threadなどを宣言しています。
#include <thread>
#include <chrono>
#include <mutex>

class SampleThread
{
private:
    std::thread _main_thread;
    std::mutex _main_mutex;

    int _counter;
    int _value;
    bool _stop_loop;

    void _StopLoop(void);
    void _Main(void);
    void _UpdateData(void);

public:
    SampleThread() : _counter(0), _value(0), _stop_loop(false)
    {

    }
    ~SampleThread() {}

    void GenerateThread(void);
    void CloseThread(void);

    int GetCounter(void);
    int GetValue(void);
    void ResetValue(const int &value);
};
sample_thread.cpp
ここでの肝はスレッドの開始、終了を行うGenerateThread(), CloseThread()関数とメモリのアクセス違反に気を遣いながら値を更新している_UpdateData(), ResetValue()関数です。
#include "sample_thread.hpp"


void SampleThread::_Main(void)
{
    const int sleep_msec = 100;
    while(!_stop_loop)
    {
        _UpdateData();
        std::this_thread::sleep_for(std::chrono::microseconds(sleep_msec));
    }
}

void SampleThread::_UpdateData(void)
{
    std::lock_guard<std::mutex> lock(_main_mutex);
    _counter++;
    _value += _counter;

    if(_counter > 100) _counter = 0;
}

void SampleThread::_StopLoop(void)
{
    _stop_loop = true;
}

void SampleThread::GenerateThread(void)
{
    _main_thread = std::thread(&SampleThread::_Main, this);
}

void SampleThread::CloseThread(void)
{
    _StopLoop();
    _main_thread.join();
}

int  SampleThread::GetCounter(void)
{
    return(_counter);
}

int SampleThread::GetValue(void)
{
    return(_value);
}

void SampleThread::ResetValue(const int &value)
{
    std::lock_guard<std::mutex> lock(_main_mutex);
    _value = value;
}
スレッドの開始/終了
まずGenerateThread()では、std::thread()を使ってこのクラスの_Main関数を別スレッドで動かすよ、と宣言しています。
逆にCloseThread()では_Main関数ないのループを終了するフラグを立てた後にjoin()関数を使って別スレッドが正常に終了するのを待っています。
join()関数で勘違いしやすいのは、この関数はあくまで"そのスレッドが終了したかを確認する"のであって"スレッドを終了させる"関数ではありません。
なのでjoinの前に止めたいスレッドの停止処理を用意してあげる必要があります。
またここでスレッドを止めないとプログラムを止めても裏でこのスレッドが回り続けてしまうので必ず呼びましょう。
void SampleThread::GenerateThread(void)
{
    _main_thread = std::thread(&SampleThread::_Main, this);
}

void SampleThread::CloseThread(void)
{
    _StopLoop();
    _main_thread.join();
}
別スレッド同士のデータの読み書き
次にデータの読み書きについてです。
以前こちらの記事で説明したように、マルチスレッドのプログラムで一番気を付けるべきはメモリのアクセス違反(segmentation fault)です。
他のスレッドが編集中のメモリに対してさらに別のスレッドが同じメモリを書き換えようとするとこのエラーが発生し、プログラムが強制的に終了してしまいます。
なのでそれを防ぐためにstd::threadと合わせて使われるのがstd::mutexです。
mutexとはメモリを書き換える際に既に他のスレッドが書き換えている場合は他のスレッドの処理が終わるのを待ちましょうと言う機能です。
このサンプルでは以下の二箇所でそれを使っています。
void SampleThread::_UpdateData(void)
{
    std::lock_guard<std::mutex> lock(_main_mutex);
    _counter++;
    _value += _counter;

    if(_counter > 100) _counter = 0;
}

void SampleThread::ResetValue(const int &value)
{
    std::lock_guard<std::mutex> lock(_main_mutex);
    _value = value;
}
上の二つの関数で共通するlock_guardが今説明したメモリへのアクセスを順番待ちする関数になります。
ただしここで気をつけたいのが、ずっとこのlockをし続けることができてしまう、と言うことです。
つまり一つのスレッドが常時メモリへのアクセスをし続けていることになり、他のスレッドがアクセスできず順番待ち=処理が止まってしまう、と言うことが起こります。
なのでmutexを使うときの鉄則として、lock_guardを呼び出す範囲は値を書き換える部分のみにしましょう。
std::lock_guard<std::mutex> lock(_main_mutex);
最後に
と言うわけで今回マルチスレッドのクラスを作ったので紹介してみました。
今後はシングルトンのクラスや複数箇所でこのスレッドにアクセスする方法などもまとめていきたいと思います。
ではでは。
MacでC++開発環境を構築してみたよ(Part1)
MacでC++環境を構築してみた Part1
概要
Macbook Airを購入したのでC++環境を構築してみました。
ここではC++のcmakeでのコンパイル開発環境整備までを書いていきます。
g++を使えるようにする。
まずはXCodeをインストールしてg++によるコンパイルができるようにします。
これはただAppStoreから引っ張ってくるだけなので簡単です。
こちらのリンクからか、あるいはAppStoreでXCodeを検索してください。
あとはインストールするのみです。
その後新しくターミナルを立ち上げg++コマンドが呼び出せるようになっているか確認してください。
合わせてmakeコマンドも入っているはずです。
cmakeを使えるようにする。
次にcmakeを使えるようにします。
cmakeとは何かについてはこちらのサイトなどがわかりやすいので参考にしてください。
平たく言うとコンパイル時にどのような手順でコンパイルしていくか(依存関係)やそのコンパイルの各種設定を自動でしてくれるビルド自動化ツールです。
なのでソースコード1つだけの時はほとんど恩恵を受けることはありませんが、ソフトの規模が大きくなればなるほどその恩恵は大きくなります。
特に個人的に嬉しいのがCMakeLists.txtで色々なところへパスを簡単に通せるので、作成した機能の役割ごとにディレクトリを分けるなどよりコードの可読性をあげ、他のプロジェクトに移植しやすかったりすることです。
なので自然とライブラリチックに単一機能に絞って書くことが習慣付くので自分は気に入っています。
cmakeのインストール
homebrewインストール
インストールにはhomebrewを使います。
homebrewのインストール方法はこちらの記事をご確認ください。
cmakeをインストールする
特に難しいことはありません。
brew install cmake
これだけです。
あとはターミナルを開き直してもらえればcmakeコマンドが出ていることがわかるかと思います。
cmakeの使い方
CMakeLists.txt
下に自分がよく使うCMakeLists.txtを掲載します。
このCMakeListsが設定しているのは以下の項目です。
- C++コンパイル時設定
- 実行ファイルの出力先(存在しない場合は自動的に生成)
- ライブラリの出力先(存在しない場合は自動的に生成)
- includeで参照するパスの指定
- 使用するライブラリがあるパスの指定
- コンパイルしたい実行ファイルに必要なソースコードを指定
- コンパイルしたい実行ファイルに必要なライブラリを指定
# Cmake version
cmake_minimum_required(VERSION 3.5)

# Project Name and Language
project(thread_sample CXX)

set(CMAKE_CXX_FLAGS "-g -O0 -Wall -pthread -std=c++11")
set(CMAKE_RUNTIME_OUTPUT_DIRECTORY ${PROJECT_SOURCE_DIR}/bin)
set(CMAKE_LIBRARY_OUTPUT_DIRECTORY ${PROJECT_SOURCE_DIR}/lib)
set(CMAKE_ARCHIVE_OUTPUT_DIRECTORY ${PROJECT_SOURCE_DIR}/lib)

# Add Subdirectory
#add_subdirectory(src)

# Add Include dir
#target_include_directories(
#  new_object_detection
#  ${PROJECT_SOURCE_DIR}/include
#)

include_directories(
    ${PROJECT_SOURCE_DIR}/include
    )

link_directories(
    ${PROJECT_SOURCE_DIR}/lib
)

add_library(thread_sample STATIC src/thread_sample.cpp)
target_link_libraries(thread_sample)

add_executable(thread_test test/thread_test.cpp
)
target_link_libraries( thread_test
        thread_sample

)
cmakeの実行場所
個人的にcmake, makeはコンパイルしたいプロジェクト内にbuildディレクトリを作成し、その中で実行することをオススメします。
この理由はコンパイル時に生成される途中経過ファイルが全てbuildファイルの中に保存されるため、他のディレクトリを汚さないことなどが挙げられます。
なのでまずbuildディレクトリを作成し、ターミナルでbuild内に移動した後、
cmake ..
を実行してください。
するとbuildの中にMakefileが生成されます。これでmakeができるようになります。
make
同じくbuildの中でmakeを実行してもらえれば、自分で指定した実行ファイルやライブラリがbinやlibの中に生成されます。
実践
ここでは自分がサンプルで作ったマルチスレッドクラスのThreadSampleを参考に実際に使ってみます。
今回はこのcpp_testerの中にあるThreadSampleを例にcmake, makeを使っていきます。
git clone
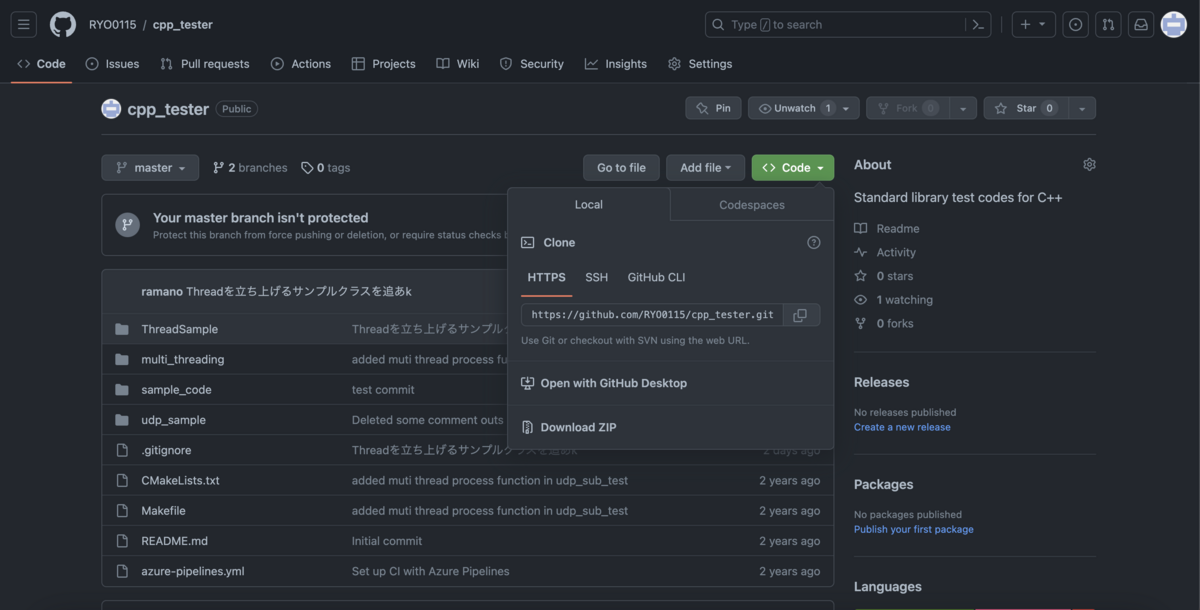
まずはこちらのレポジトリをローカル(自分の手元のパソコン)にclone(ダウンロード)してきます。
保存したいディレクトリにターミナルで移動して以下のコマンドを実行いただくか、下の画像にあるDownload zipからzipファイルでダウンロードしてください。
git clone https://github.com/RYO0115/cpp_tester.git
buildディレクトリを作る
次にcpp_tester/ThreadSampleの中にbuildディレクトリを作成し、ターミナルでその中に移動します。
cmake
ここで実際にcmakeを実行します。
次のコマンドを実行してください。
cmake ..
ここでcmakeの後の".."はCMakeLists.txtの場所になります。
もしbuildディレクトリの中にCMakeLists.txtがある場合は、このコマンドは"cmake ."になります。
ただ基本的にCMakeLists.txtとcmakeを実行する場所は分けることをオススメします。
それは上にもちらっと書きましたが、cmake, makeの中間ファイルが全てコマンドを実行した場所に保存されるからです。(CMakeLists.txtで保存場所を変更すればその限りではありませんが)
なので基本的には分けておいた方が無難でしょう。
make
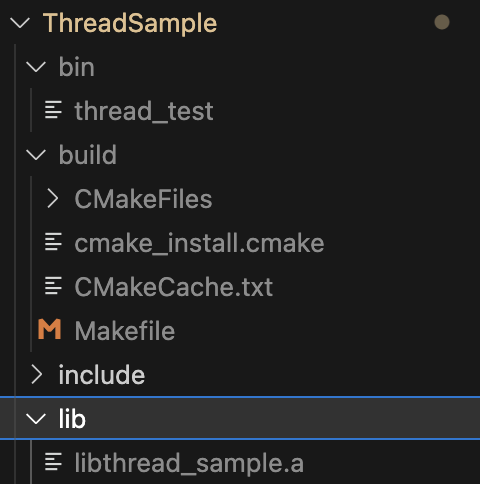
cmakeを実行したことでbuildの中を覗くとMakefileが生成されているかと思います。
これでコンパイルの準備が完了です。
実際にmakeしてみましょう。build内で以下のコマンドを実行してください。
make
これでsrc,test内のソースコードがコンパイルされます。
ファイルの確認
最後に今回のcmake, makeで出来上がったものを確認します。
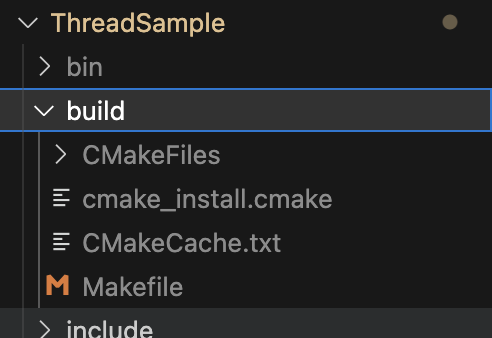
thread_testが実行ファイル、libthread_sample.aが今回静的ライブラリ化したファイルになります。
他のソースコードでThreadSampleクラスを使いたい場合は、includeの中にあるthread_sample.hppとこのlibthread_sample.aへパスを通せば使えるようになります。
最後に
と言うわけでC++のコンパイルができる環境構築と実行方法をまとめました。
CMakeLists.txtは上で書いたものの数倍数十倍の機能があるので、必要に応じてどんどんいじってください。
ではでは。
【ChromeCast】画面シェア機能 ChromeCastはどの環境で使えるのか?【Windows】【Mac】【Android】【iOS】
画面シェア機能 ChromeCastはどの環境で使えるのか?
概要
最近自分の周りでどうやって手元のデバイスの映像をテレビに飛ばせばいいのか(しかも音声付で)、ということで議論が沸き起こっています。 (その火種になったのは自分の可能性が大いにありますが)
そもそもテレビに何かキャストしたいとあまり思わない人間なので今までスルーしてきましたが、今自分の手元を見ると、
と、比較検証すべきデバイスがすべてそろっていることに気づきました。
というわけで今回はどのデバイスであればテレビに快適に映像が映せるのかを確認してみました。
なお、ここでは自分が頻繁に使用するSpotv Nowのサッカー映像をもとに検証していきます。
実験環境 (キャスト先)
大層なタイトルですが、今回キャスト先として2017年6月発売SONYのKJ-43X8000Eという5年以上前のAndoroid TVを使用しています。
4K対応テレビですが世代がかなり前なので、ここ最近でテレビを買い替えた方であれば恐らくこのテレビよりも高いスペックになっているかと思うのでベンチマークとしては悪くない対抗機だと思います。
もちろんこちらのテレビはネットワークに接続しています。
ネットワークへの接続設定については、各メーカーごとに違いますので各自のテレビメーカーから確認して下さい。("メーカー名 型番 ネットワーク 接続方法" とググれば大体でてきます)
比較内容
概要で説明した通り、Spotv Nowで見られるサッカーのフル動画を試しに5分ずつ視聴しています。
ライブ映像だとフル動画よりもよりラグや読み込みなどが入る可能性がありますので、あくまで参考値です。
またChromeCastはGoogleの機能なのでブラウザは全てGoogle Chromeで確認しています。
接続方法(キャストのやり方)
PC (Windows, Mac)
キャストの方法は簡単です。 まずは開きたいページをGoogle Chromeで開きます。
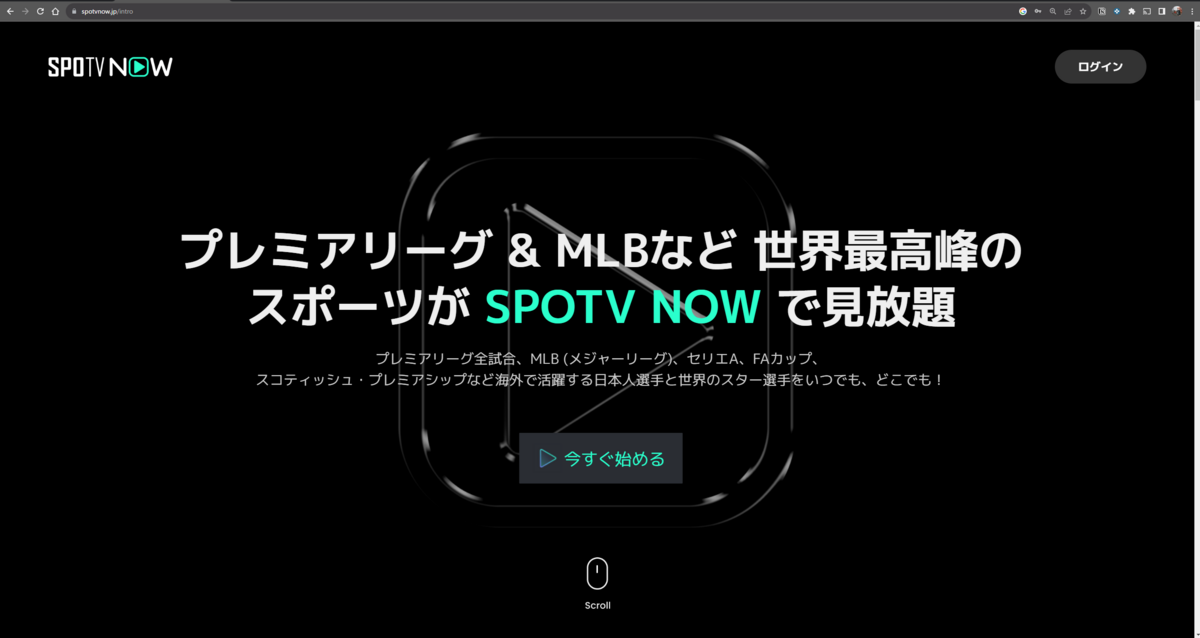
その後画面右上のメニューボタンからキャストを選択してください。
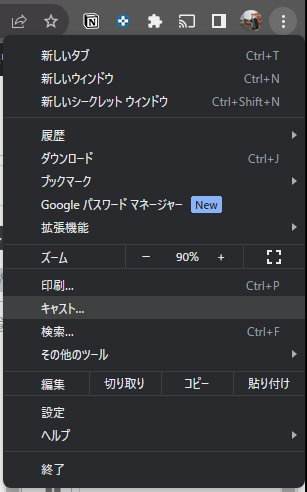
するとしたのように接続可能なデバイスが一覧になって出てきます。
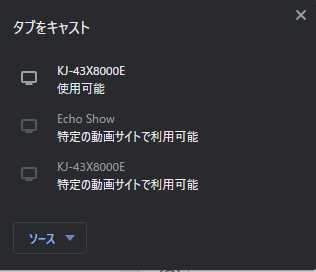
後は接続したいデバイスをクリックすればテレビに接続されます。
(デスクトップは写真を撮ったのですが、あまりにハーネスが汚いので掲載しません)
Windows ノートPC
Android
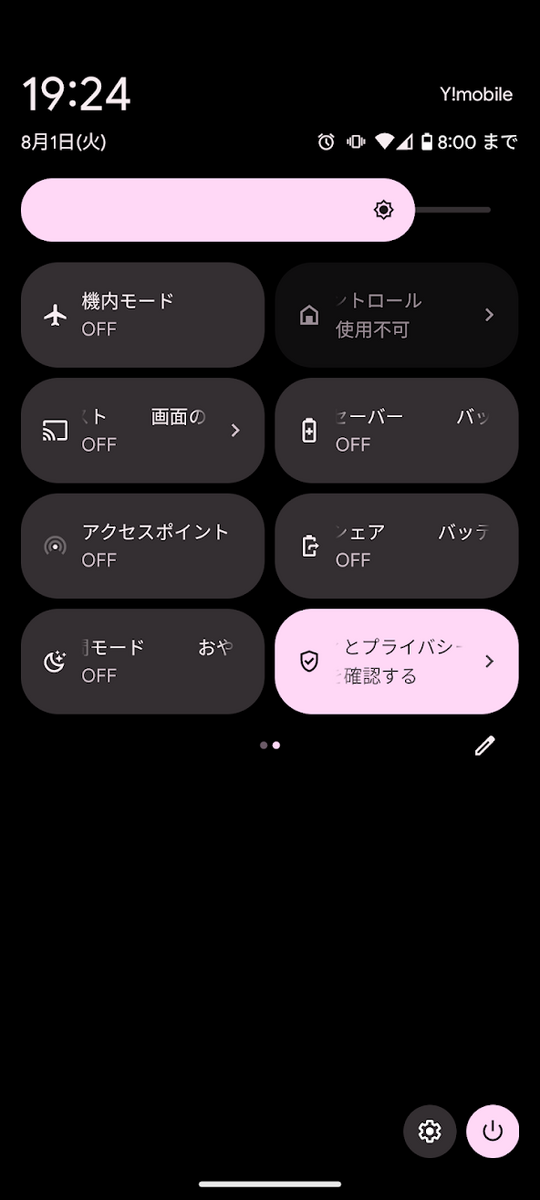
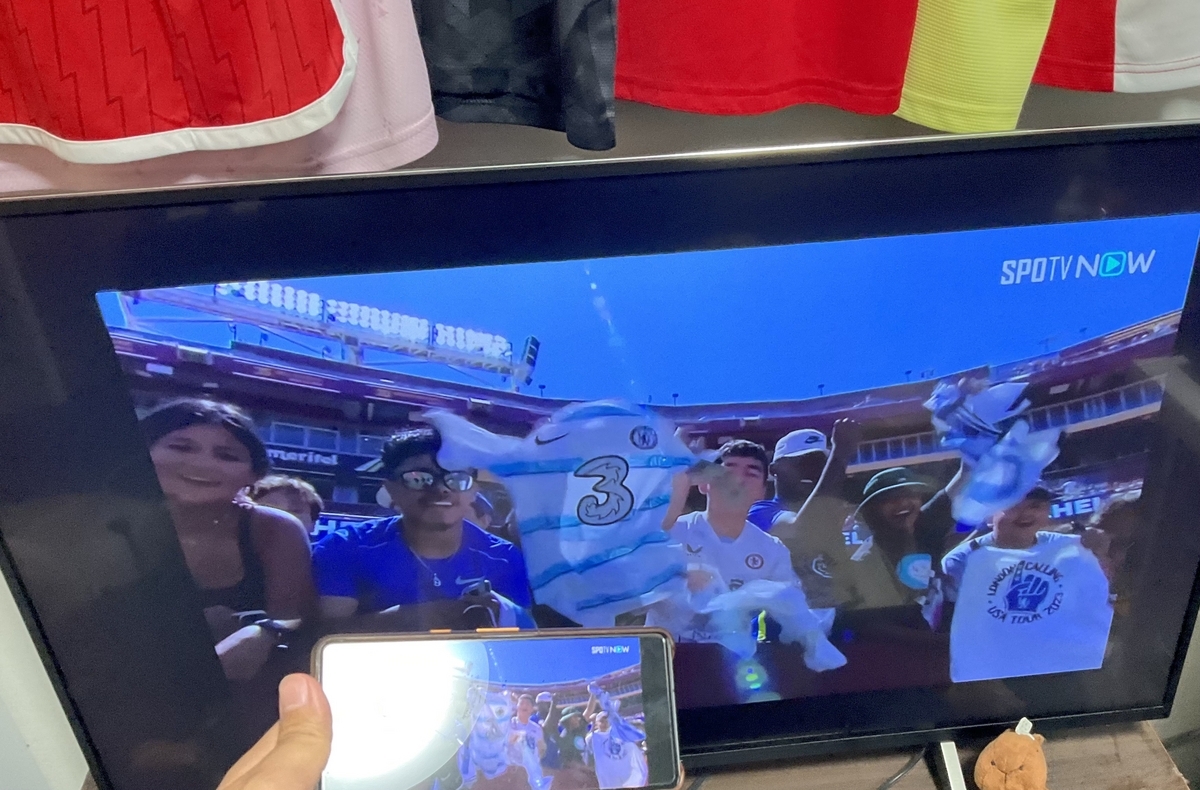
画面上からスライドさせて表示するメニュー画面に画面のキャストというボタンがあります。
こちらをタップしていただき、キャスト先のデバイスを選択するだけです。
iOS
残念ながらiOS単体ではChromeCastはできませんでした。
iOSデバイスをお持ちの方は下にあるようなChromeCastデバイスを購入し、テレビに差し込む必要があります。
ただし、こちらはミラーリングにしか対応していなさそうなので、もしかしたら映像は出るけど音声は出ない、ということになるかもしれません。
テスト結果
| デバイス | 有線/無線 | 映像 | 音声 | 映像の安定性 | 手軽さ |
|---|---|---|---|---|---|
| Windows PC (デスクトップ) | 有線 | ◎ | ◎ | ◎ | 〇 |
| Windows PC (ノート) | 無線 | ◎ | ◎ | ◎? | ◎ |
| MacBook (ノート) | 無線 | ◎ | ◎ | ◎? | ◎ |
| Android | 無線 | ◎ | ◎ | △ | ◎ |
| iOS | 無線 | 〇 | × | 〇 | - |
結果としてはパソコンは全て安定して映像をテレビにキャストすることができました。
意外にも無線で繋いだノートPCでも安定して映像を映すことができました。(これは結構ありがたい)
テレビで見るときはソファなど少し離れたところで寛ぎながら見る人が多いかと思いますので、これはうれしい結果です。
それに対しAndroidはライブ映像ではないにも関わらずブツブツと映像、音声が途切れるのが気になりました。
そして一番残念なのはiPadだとそもそもChrome Castできませんでした。
一応ミラーリングまでは怪しいアプリを使えばできますが、いろいろとリスクもありそうなのでお勧めはしません。なので手軽さは評価無しとしました。
実際使う際はライブ映像なので、無線での映像の安定性についてはまだ懸念が残っているので今後試した際にまたアップデートしたいと思います。
最後に
というわけで、今回いくつかのデバイスでChromeCastを使って映像を音声付でテレビに映すことができるのかを試してみました。
自分としてはMacbookから簡単に映せるのは個人的に驚き&ありがたい結果なので、今後は活用していこうと思います。
少しでもこちらの内容がためになれば幸いです。
ではでは。
2023年 MacBook Air 開発環境構築
MacBook Air 開発環境構築
概要
今回はPythonとTypescriptの開発環境を入れていきます。
また追々C++環境もApple clangのものではなくgccのg++を使えるようにしたいと思っています。
Homebrew Install
Mac環境に数々のツールを入れるための必須ツールであるパッケージ管理ツールHomebrewをインストールしていきます。
インストールは簡単です。
まずはターミナルを開き、以下のコマンドを順番に実行していきます。
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"


(echo; echo 'eval "$(/opt/homebrew/bin/brew shellenv)"') >> /Users/ryota_amano/.zprofile

eval "$(/opt/homebrew/bin/brew shellenv)"
これでインストール完了です。
Git
インストール
次にコード管理のためにGitをinstallしていきます。
ここではHomebrewからインストールします。
brew install git
Gitのインストールはこれで完了です。
ユーザ名、アドレスの設定
次にGitでコミットするために必要なユーザ名とメールアドレスを設定します。
git config --global user.name "ユーザ名"
git config --global user.email "メールアドレス"
これでコミットなどのGit機能が使えるようになります。
C++環境構築
長くなったので別記事としました。
Python3.9以降 環境構築 (pyenv + pipenv環境構築)
以前WSLで構築したpyenv + pipenv環境を構築していきます。
M2 Macbook AirなのでPython3.9以降を想定した環境を構築していきます。
pyenvインストール
pyenvもHomebrewでインストールしていきます。
brew install pyenv
これでpyenvがインストールされたので、次にPythonのバージョンを指定してインストールしていきます。
まずはインストール可能なバージョンを確認します。
pyenv install -l
これでインストール可能なバージョンがリストで表示されます。
今回は一番最新の3.11.4をインストールしていきます。
pyenv install 3.11.4
しかしここで問題が、
下のようにlzmaというライブラリがないですよ、とwarningがでます。
一度pyenvでインストールしたpython 3.11.4をuninstallします。
pyenv uninstall 3.11.4
綺麗な状態で足りないライブラリと設定をしていきます。
brew install openssl readline sqlite3 xz zlib tcl-tk
これで再度pyenv installを試していきます。
pyenv install 3.11.4
これで無事にインストールできました。
pyenv 適用
自分はどのディレクトリでもこの3.11.4をベースに動いて欲しいので以下のコマンドを実行しました。
pyenv global 3.11.4
もし特定のディレクトリでのみ動いて欲しいのであれば、そのディレクトリに移動した後に以下のコマンドを実行してください。
pyenv local 3.11.4
次にルートディレクトリにある ~/.zshrcファイルに以下の設定を追加します。
export PYENV_ROOT="$HOME/.pyenv"
command -v pyenv >/dev/null || export PATH="$PYENV_ROOT/bin:$PATH"
eval "$(pyenv init -)"
その後この設定ファイルを再度読み込むためにターミナルを再起動する or 以下のコマンドを叩いてください
source ~/.zshrc
これでpyenvのインストールは完了です。
pipenvインストール
Pythonの仮想環境を作成するためにpipenvをインストールしていきます。
pipenvのインストールは先ほどpyenvでインストールした中に入っているpipを使ってインストールします。
pip install pipenv
pipenvを使った環境構築
pipenvの使い方についてはこちらの記事を参考にして下さい。
TypeScript/JavaScript環境構築
ここではTypeScript/JavaScriptの開発環境を構築するために以下の各種ライブラリ等をインストールしていきます。
- nodebrew
- Node.jsのバージョン管理ツール
- Node.js
- JavaScriptアプリを作る強い味方. さまざまな機能がライブラリ化されてます。
nodebrew/Node.jsのインストール
公式のインストーラもありますが、ここもHomebrewでインストールしていきます。
brew install nodebrew
次にnodebrewの設定をします。
nodebrew setup
これで必要な設定が$HOME/.nodebrew/に生成されます。
これを.zshrcにもパスを書いていきます
下の一文を~/.zshrcに追加してください。
export PATH=$HOME/.nodebrew/current/bin:$PATH
またまた設定を反映するためにターミナルを再起動 or 以下のコマンドで反映してください。
source ~/.zshrc
その後最後にnodebrewインストール後に最新版のNode.jsをインストールします。
nodebrew install-binary latest
念の為、インストールしたNode.jsのバージョンを確認しましょう。
node -v
これでバージョン情報が表示されたらインストール成功です。
TypeScriptのコンパイラインストール
Node.jsをインストールするとnpmというJavaScriptのライブラリ管理ツールもインストールされます。
こちらを使ってコンパイラをインストールしていきます。
npm install -g ts-node
npm install -g typescript
最後にコンパイラのバージョンを確認してインストールできているかを確認します。
tsc -v
これでバージョンが表示されればコンパイラのインストール完了です。
Prettier(コード整形ツール)インストール
まずはパッケージ管理ツールのyarnをインストールします。
npm install -g yarn
このyarnを使ってPrettierをインストールします。
yarn add -D 'prettier@^2'
ESLint(コーディング規約チェックツール)インストール
コーディング規約に準拠しているかを自動で確認してくれるESLintをインストールします。
yarn add -D 'eslint@^8'
